1.1 Rundungsfehler und Fehlerpropagation
Maschinenzahlen (1.1.1–1.1.3)
Absoluter und relativer Fehler
Sei eine Approximation von .
- der absolute Fehler ist
- für ist der relative Fehler
Maschinenzahlen
Seien eine Basis , , eine Mantissenlänge und ein Exponentenbereich gegeben. Die Menge der Maschinenzahlen ist
Die Bedingung heisst Normalisierung.
Hier ist die Zahlenlinie, mit den darauf liegenden floats. Für float64 ist und .
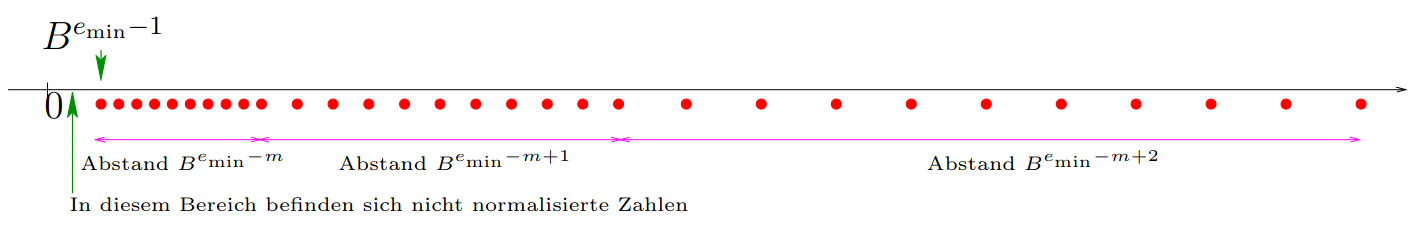
Note: ist eine endliche, diskrete Teilmenge von , die unter nicht abgeschlossen ist, also ist Rundung unvermeidbar.
Note (eps): Die Konstante ist der Abstand von zur nächstgrösseren Maschinenzahl, für float64 also (np.finfo(np.float64).eps).
Der IEEE-754-Standard garantiert außerdem, dass jede Grundoperation korrekt gerundet wird: Für und gilt mit . Eine einzelne Operation ist also immer relativ genau.
Auslöschung (1.1.9–1.1.10)
Durch Subtraktion ergibt dich das folgende noise amplifizierende Problem.
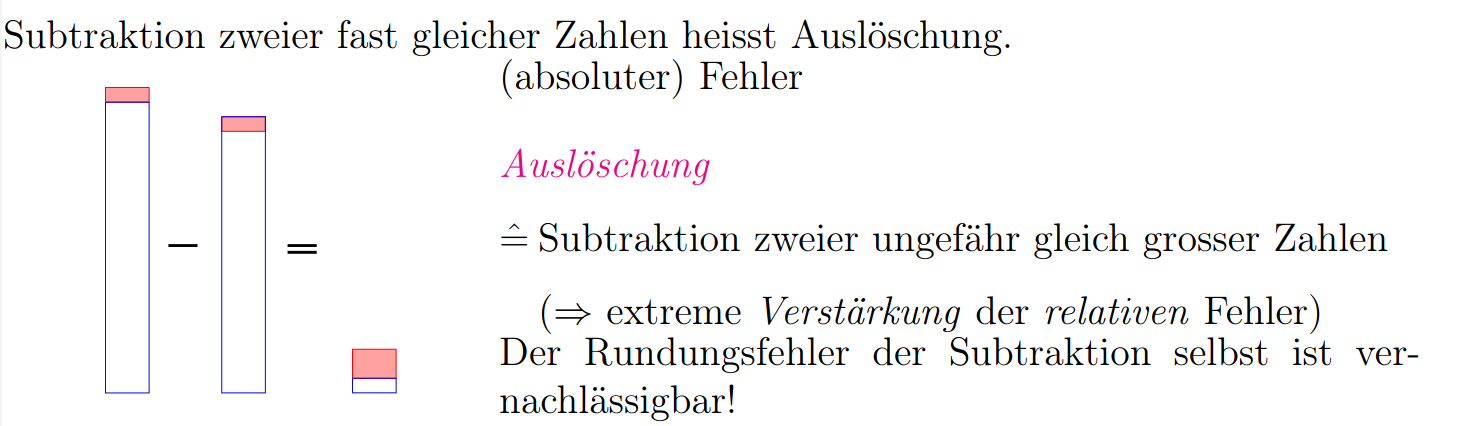
Der Verstärkungsfaktor wird beliebig gross, wenn .
Der Rundungsfehler der Subtraktion selbst ist dabei vernachlässigbar. Die bereits vorhandenen Fehler werden lediglich relativ zum kleinen Ergebnis sichtbar.
Example: Seien und mit relativem Fehler der Grössenordnung behaftet, d.h. ab der 7. Nachkommastelle verfälscht (markiert mit ):
Die verfälschten Ziffern rücken nach vorne, und das Ergebnis ist bereits ab der 3. Stelle falsch. Der relative Fehler ist also von auf gewachsen.
Beispiel: Auslöschung beim Differenzquotienten
Rein imaginärer Schritt
- Nehmen an Funktion sehr glatt
- dann muss sie analytisch sein → darstellbar als Potenzreihe
- Mit Taylor finden wir die Koeffizienten.
- daraus kriegen wir
- die Subtraktion ist weg → keine Auslöschung
- Die Restterme sind , konvergiert also schneller als naive methode
Richardson
- wir starten mit dem symmetrischen Differenzquotient
- Taylor-Entwicklungen von und heben sich alle geraden Potenzen von auf
- die Koeffizienten nicht von abhängen und nur gerade Potenzen auftreten
- mit dem kleinsten und der Elimination
- Es gilt dann für den Fehler
- wir haben also nicht die Auslöschung verhindert, die Approximation konvergiert aber so schnell, dass diese zu vernachlässigen ist.
V-Form: Verkleinern von hilft nur bis , danach dominiert die Auslöschung.
- nie eine bessere Genauigkeit als
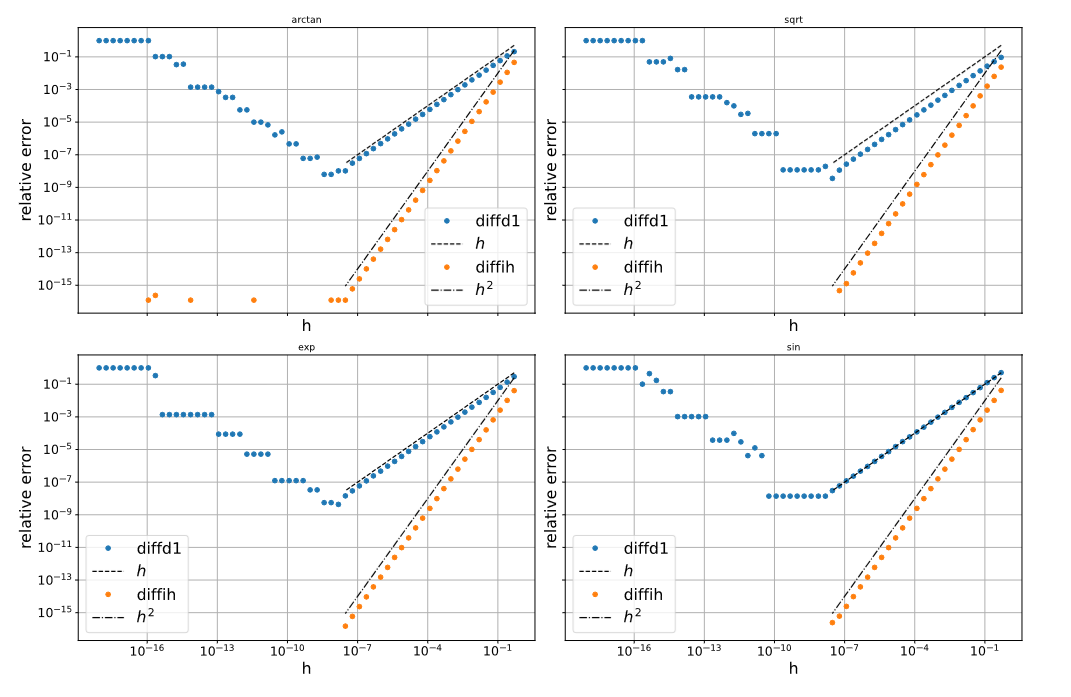
→ Schranke ist pessimistisch, da sich Rundungsfehler teilweise gegenseitig aufheben, aber die Größenordnung von stimmt
Auslöschung lässt sich auf zwei Arten bekämpfen:
- schneller Konvergieren (Richardson)
- vermeidet die Subtraktion vollständig (imaginärer Schritt)
1.2 Rechenaufwand
Die asymptotische Komplexität zählt elementare Operationen () im Worst Case für .
→ kein verlässliches Mass für die tatsächliche Laufzeit
Hängt auf modernen Rechnern von … ab:
- RAM bandwidth
- cache levels
- prozessor kerne, BLAS/CUDA, etc…
1.3 Rechnen mit Matrizen
Durch schlaues erkennen von Strukturen, kann man Matrixmultiplikation oft schneller als machen!
-
Struktur ausnutzen: Statt mit Diagonalmatrix in zu berechnen, skaliert man die Zeilen:
D.diagonal()[:, np.newaxis] * Ain . -
Klammerung wählen: kostet , dagegen .
-
Niedrigen Rang ausnutzen: mit berechnet man spaltenweise über Teilsummen (
cumsum) in statt . -
Kronecker-Produkt nie aufstellen: Mit ist , also genügen zwei kleine Matrixprodukte.
-
Vektorisieren: Keine expliziten Schleifen über Array-Elemente, und nie
np.vectorizeverwenden, da es intern doch nur eine Schleife ist. -
Speicher bewusst verwalten:
- Views statt Kopien verwenden.
- Arrays einmal vorab mit dem richtigen
dtypeallozieren, statt sie zu erweitern. - Eine echte Kopie erzwingen, wo sie nötig ist.